社内生成AIの構築はどこから始める?自社に合う方法の選び方
「社内文書を学習させる」と「検索して答えさせる」は何が違うのか、調べ始めた方も多いはずです。
既製サービス、クラウド、自社サーバのどれで作るのか、比べる軸が定まらず立ち止まっていないでしょうか。
比べる軸は3つだけです。読み終えるころには、上司に出す検討案を書き始められます。
生成AIに社内情報を学習させるのと、検索して答えさせるのは何が違うのか
汎用チャットが社内規程に答えられないのは、社内文書を参照していないからです。手段は追加学習(ファインチューニング[1])と、文書を検索して答えさせるRAG[2]の2つで、規程の改定を反映しやすく、閲覧権限もかけられるRAGを基本に考えます。
| 項目 | 追加学習 | RAG |
|---|---|---|
| 文書更新の反映 | 再学習が要ることがある | 置き場の文書を更新する |
| 閲覧権限のかけやすさ | 人ごとに分けにくい | 文書ごとに絞れる |
| 回答の根拠の示しやすさ | 示しにくい | 参照箇所を示せる |
たとえるなら、追加学習は規程を丸暗記してもらう形、RAGは規程集を開いて答えてもらう形です。追加学習は、最新情報を得る検索の代わりにはなりません(Microsoft)。
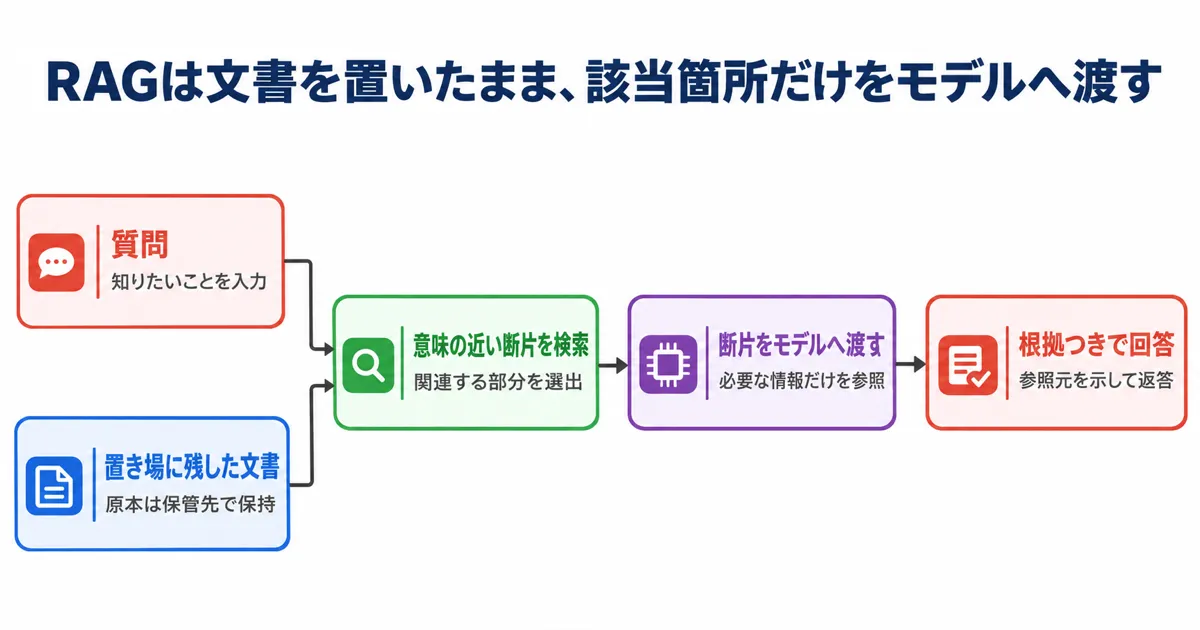
RAGは、質問に意味の近い文書の断片を探し、それをモデルに渡して、根拠つきで答えます。
「RAGなら、社内文書は外へ出ないの?」
法務にこう聞かれたら、どう答えますか。RAGでも、検索した文書の一部はモデルへ送られます。提供元のMicrosoftによると、Azure OpenAI[3]を含むモデルでは、入力と出力はモデルの中に保存されず、許可なく基盤モデルの訓練にも使われませんが、不正利用の監視では、承認を受けて外さない限り別に保存されます(Microsoft)。
Amazon Bedrock[4]では、2026年11月時点で最長30日の保持の対象がモデルごとに異なり、地域をまたぐ処理では保存先も変わります(AWS)。
法務やセキュリティ部門とは、次の3つを契約プランと使うモデルごとに、提供元の規約で確かめてください。
- 送信データの学習利用の有無
- 保存期間
- 保存先
社内生成AIの構築方法は、既製サービス・クラウド・自社サーバのどれを選ぶか
学習と検索の違いを押さえたら、次の迷いは「うちはどの方式で作ればいいのか?」です。製品の機能表を見比べるより、扱う情報、権限管理、運用する人手で比べると、自社に合う方式を1つに絞れます。
3つの方式を並べて比べる
| 項目 | 既製サービス | クラウド | 自社サーバ |
|---|---|---|---|
| 製品の例 | Microsoft 365 Copilot[5] | Azure OpenAI、Amazon Bedrock | ローカルLLM[6] |
| 向く情報 | グループウェア内の文書 | 社外へ送れる条件を確認した文書 | 社外に送れない情報 |
| 権限管理 | Copilotは本人が閲覧できるデータだけを使う(Microsoft) | 自社で設計する | 自社で設計して管理する |
| 運用する人手 | 少なく済む | 開発と監視の担当が要る | GPU[7]調達、モデル更新、障害対応も担う |
つまり、既製サービスから自社サーバへ進むほど、自社で担う仕事が増えます。
では、自社サーバにはどれほどのGPUが要るのでしょうか。GPU事業者のNTTPCが2026年の記事で示した検証用の最小構成の目安は、13〜30B級モデル(Bはモデルの規模を示す単位)のRAG・要約検証でGPUメモリ24〜48GBです。
これは単一セッション[8]の前提です。部門運用の同時実行は5〜20セッションが例で、増えるほど推論中のメモリもほぼ直線的に増えます(NTTPCコミュニケーションズ)。
3つの問いの順に方式を絞る
- 文書が既存のグループウェアにあり、その権限を使えますか? 使えるなら既製サービスから始めます。
- 独自の権限や社内システム連携が要り、開発担当を確保できますか? できるならクラウドを選びます。
- 上の方式で、法務とセキュリティの確認が通らない文書はありますか? 学習利用、保存期間、保存先を確かめても通らない文書だけ、自社サーバを検討します。
普段の文書は既製サービス、機密度の高い文書だけ自社サーバ、という併用も選べます。対象にしたい文書を1つ思い浮かべて、3つの問いに順に答えてみてください。
社内文書の閲覧権限を回答に反映する方法と、運用体制の決め方
方式の見当がついても、「人事情報が別の部署の人の回答に出たら……」という怖さは残るのではないでしょうか。
検索の段階で閲覧できる文書だけに絞る
回答を作った後に隠すのではなく、質問者が閲覧できる文書だけを検索の候補にしてください。権限の無い人には、書庫の鍵を渡さないイメージです。そのために、元の文書の権限情報を検索用の置き場へ同期します。
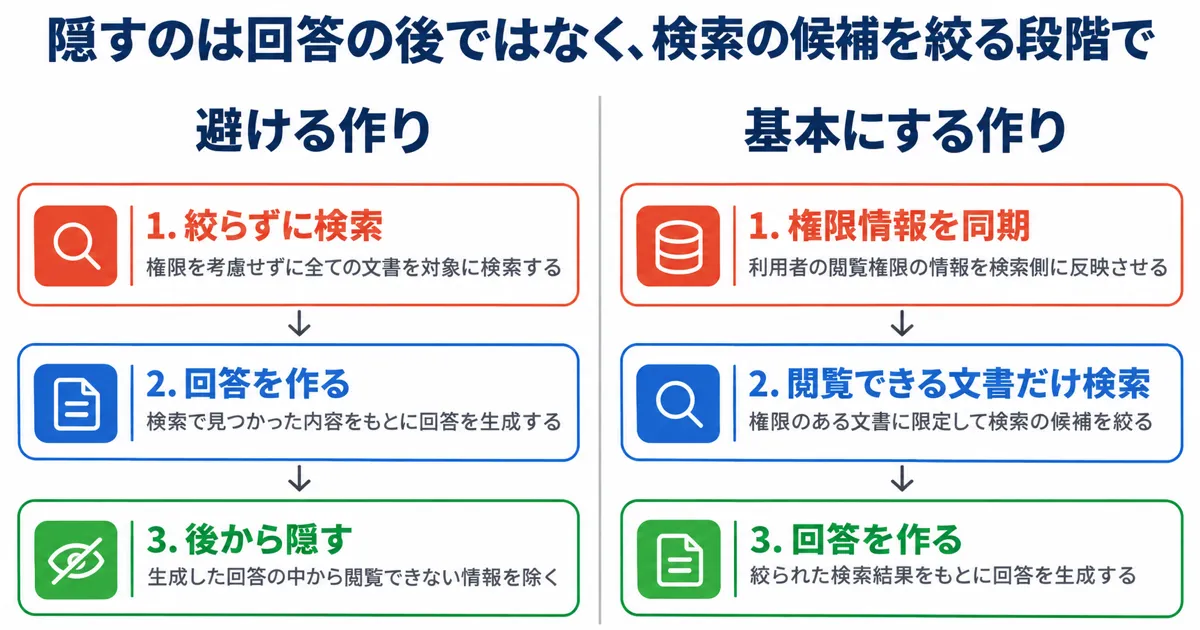
たとえばAzure AI Search[9]のSharePoint[10]権限取り込み(2026年11月時点でプレビュー機能)では、サイトやフォルダなど親の権限の変更は自動で検知されず、再同期が要ります(Microsoft)。人事異動や退職がいつ反映されるかを、導入前に確かめてください。
元の共有設定が緩いと、そのまま回答に出てしまいます。Microsoftの文書も、権限を見直していない予算サイトの情報が、閲覧できてしまう社員への回答に使われる例を挙げています(Microsoft)。接続する前に共有設定を棚卸しし、整理が済んでいない人事情報や契約情報は最初の対象から外してください。
運用の仕事ごとに担当を決める
| 運用の仕事 | 担当の例 |
|---|---|
| 文書の更新 | 文書を持つ部署 |
| 回答精度の改善 | 情報システムやDX推進 |
| 権限の確認 | 情報システム |
| 問い合わせ対応 | 窓口は情報システム、中身は文書を持つ部署 |
文書の中身は持ち主の部署に任せ、情シスだけで抱えない分担にします。ソフトバンクの全社RAG基盤(2026年の記事時点で利用者1万9000人、1社の事例)では、データ管理者の確認と責任者の承認を経て、組織単位で公開範囲を指定しています(@IT(ITmedia))。
構築を外部へ委託しても文書の更新と権限の確認は社内に残るため、必要な人手はこの2つを前提に見積もってください。
社内文書RAGの構築手順、小さく試して全社へ広げる順番
権限の絞り方と運用の分担を決めたら、次は試す段階です。「全社に出して外したら、信頼を失う……」という心配は、範囲を絞れば小さくできます。
ステップ1:1部署の1種類の文書で試す
総務の社内規程や情シスの操作マニュアルのように、閲覧範囲が広く、質問が多く、担当者が正誤を判定できる文書を選びます。スキャンしたPDFや表が正しく読み取れるかも、ここで確かめてください。
ステップ2:現場の質問で回答を確かめる
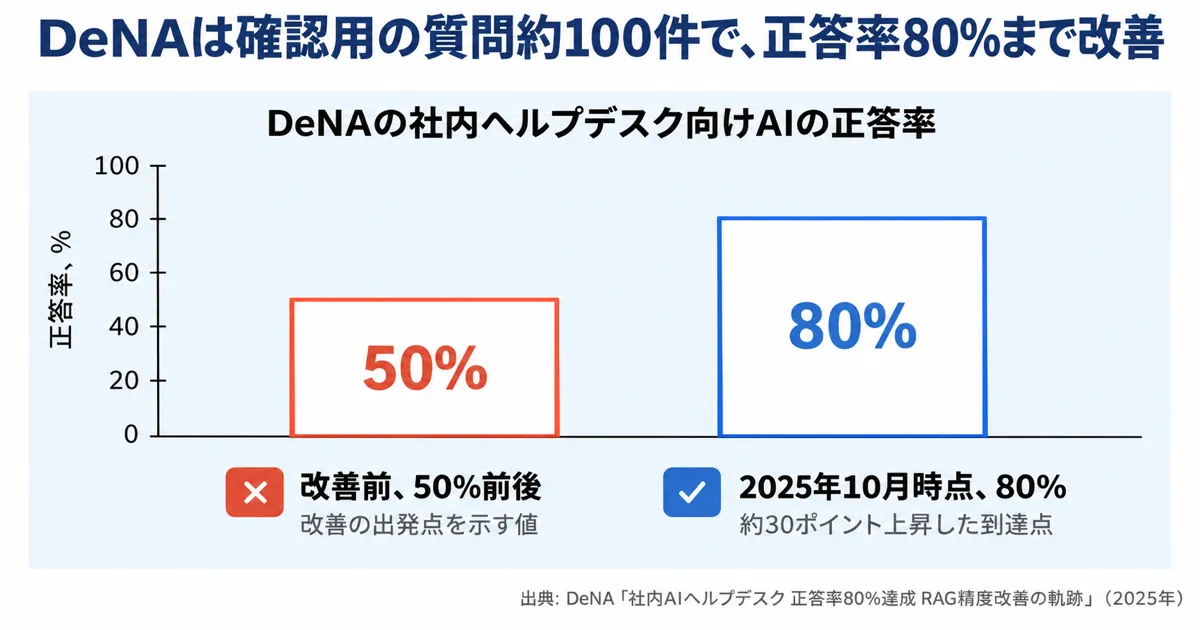
現場から出た質問と正解の組を、文書の担当者と作ります。DeNAの社内ヘルプデスク向けAI(1社の事例、IT領域の質問が対象)は、1か月分の問い合わせから確認用の質問を約100件作り、2025年10月時点で正答率を50%前後から80%まで上げました(DeNA)。
確かめるのは次の4点です。
- 正答しているか
- 根拠の箇所が合っているか
- 文書に無いことを無いと返せるか
- 権限の無い利用者に出ないか
検索して答えさせる作りでも誤答は残ります。合格の基準は、試す前に決めてください。
ステップ3:基準を満たしたら順に広げる
回答の基準を満たし、権限の確認に問題が無く、更新の担当が機能し、試行した部署で使われ続けているなら、機密度の低い文書から順に対象を増やしましょう。満たさないときは、文書の整備や検索対象の絞り込みに戻ります。
社内文書を使える生成AIの検討案は、何から書き始めるか
ここまで読んで、自社に合いそうな方式の見当がついてきた方もいるのではないでしょうか。上司に出す検討案は、次の順で書き始めてください。
- 現場で答えられなかった質問を集め、試す文書の候補を1つ選びます。
- その文書の機密度、閲覧範囲、担当できる人を書き出し、方式を仮に決めます。
- 試す範囲と広げる基準を1枚にまとめ、法務やセキュリティ部門の確認項目を添えて上司に出します。
現場から届いた「答えてくれなかった質問」を1件書き留めるところから、始めてみてください。
用語の注釈
- ファインチューニング 追加の訓練でモデル内部の数値を調整し、特定の作業に合わせる手法です。 ↩
- RAG 質問に関係する文書を検索し、その内容をもとに生成AIに答えさせる作りです。 ↩
- Azure OpenAI MicrosoftのクラウドAzure上でOpenAIのモデルを使えるサービスです。 ↩
- Amazon Bedrock AWS上で複数の提供元の生成AIモデルを使えるサービスです。 ↩
- Microsoft 365 Copilot Microsoft 365の中で使う生成AIの既製サービスです。 ↩
- ローカルLLM 自社のサーバなど手元の環境で動かす大規模言語モデルです。 ↩
- GPU 生成AIのモデルを動かす計算に使う半導体です。 ↩
- セッション AIとの一続きのやり取りの単位です。 ↩
- Azure AI Search Microsoftのクラウドで提供される検索サービスです。 ↩
- SharePoint Microsoftの文書共有サービスです。 ↩