Jevとは、文章を書かないAIとLLMの違いと向いている判定
「Jevという、文章を書かないAIが出たらしい」と耳にして、ChatGPTと何が違うのかと調べ始めた方も多いはずです。
問い合わせの振り分けやデータの分類を、ChatGPTのような文章を書くAIに任せている開発者の方もいるのではないでしょうか。件数が増えるほど膨らむ利用料や、まれに形の崩れた答えが返ってくることに手を焼いているかもしれません。「安くなるなら移したいが、精度は落ちないのか?」と立ち止まっている方もいるはずです。
Jevができることは、選ぶ・点を付ける・確率を出すの3つだけで、仕組みは思いのほか単純です。公式の資料に加えて、実際に測った検証記事もすでに公開されています。
Jevとは、文章を書かずに判断だけを返すAI
Jevは、あらかじめ決めた選択肢や基準に沿って、判断だけを返すAIです。ChatGPTのように文章を書くAI(LLM[1])とは違い、答えを文章で書くことはありません。
TypeSafe AIが公開した、判断だけを返すモデル
Jevを出したのは、TypeSafe AIという会社です。発表は2026年9月15日で、同社はこの種類のモデルを「System One」と名付けました(TypeSafe AI)。
公式の定義は、ソフトウェアがそのまま使える、速く構造化された判断をするためのモデルです。問い合わせメールのような形の決まっていない文章を受け取り、返すのは形の決まった答えと確率だけ。
CEOのDiogo Almeida氏は、元OpenAIで強化学習の専門家と紹介されています。9月15日の公開は、限られた利用者向けの早期提供でした(Qiita(pds_siken))。
選ぶ・点を付ける・確率を出すの3つだけ
Jevができる判断は、次の3種類に限られます(Zenn(serada))。
- Choice(選ぶ):問い合わせを「返品」「請求」「故障」の窓口から1つ選びます。選択肢は最大255個まで置けます(TypeSafe AI)
- Score(点を付ける):緊急度を「低・中・高・至急」のような段階で採点します。採点の基準(ルーブリック[2])に照らし、段階ごとの確率で重み付けした平均を返します
- Noul(確率を出す):「この文面は解約をほのめかしているか」が正しい確率を0〜1で返します
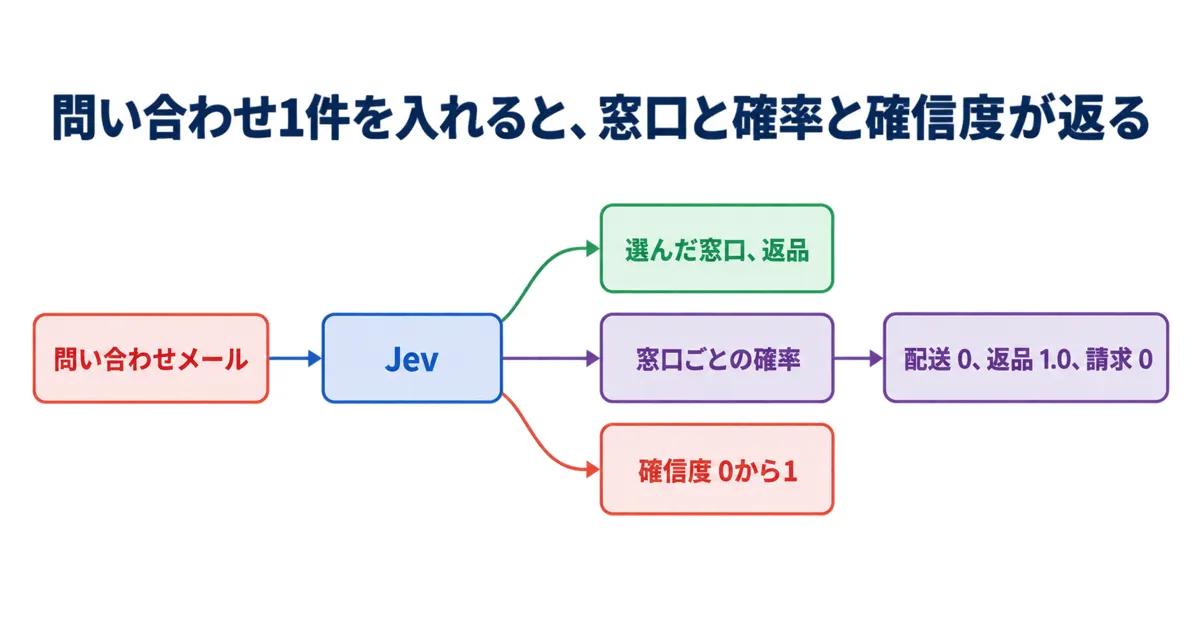
Choiceの答えには、選んだ選択肢、全選択肢の確率(合計すると1)、確信度の3つが入ります。確信度は、AIがその答えにどれだけ自信を持っているかを0〜1で表した数だと考えてください。公式の説明にある例では、配送・返品・請求の3つの窓口から選ばせ、返品の確率が1.0になっています。
System Oneという名前の由来
名前は、心理学者カーネマンの著書『ファスト&スロー』から来ています。人の判断を、速く直感的な「システム1」と、遅くじっくり考える「システム2」に分ける考え方です(TypeSafe AI)。
職場にたとえるなら、届いたメールを見てすぐ担当部署に回すのがシステム1、相手に合わせて返信文を考えるのがシステム2。Jevは前者の速い判断を受け持つモデルで、言葉を重ねながら答えるLLMとは役割が違う、という位置づけになります。
JevとLLMの違い、出力の形と答えが返るまでの時間
判断だけを返すAIだと分かったところで、文章を書かないことは仕組みの上でどんな違いになるのでしょうか。一番の違いは、LLMが答えを文章で書くのに対し、Jevは決めた答えの確率を一度に出す点です。
LLMは文章を書き、Jevは答えの確率を出す
| 項目 | LLM(ChatGPTなど) | Jev |
|---|---|---|
| 出力の中身 | 自由な文章 | 決めた型の答えと確率 |
| 答えの作り方 | 1語ずつ書き進める | 全選択肢の確率を一度に出す |
| 返りうる答えの範囲 | 実行するまで分からない | 設計の時点で決まっている |
| 応答時間(提供元の発表) | 既存モデルで3〜329秒 | 70〜500ミリ秒 |
| 出力の料金 | 出力の量に応じてかかる | かからない |
つまり、Jevは文章を書かない代わりに、答えが速く返り、返ってくる答えの範囲も事前に決まります。表の応答時間は、提供元が発表した数字です(TypeSafe AI)。
壊れたJSONが返らない理由と、それでも残る間違い
LLMのAPI[3]で分類させるとき、JSON[4]モードやfunction calling[5]で出力の形を指定している方も多いはずです。それでも、まれに形の崩れた答えが返り、例外処理を書き足した経験はないでしょうか。
Jevは、選択肢の外の答えを返せない作りです。Jevとそれに似たモデルを1,200件の業務の判定で調べた論文でも、型の外の答えはどの条件でも0%で、判定の精度が大きく落ちた条件でも変わりませんでした(arXiv(Yu Sun、Junhao Xu))。
ですから、LLMとJevは取り合う関係ではありません。返信文を書く仕事や込み入った推論はLLMに、選ぶ・採点する・真偽を見る仕事はJevに、と分担して考えてください。
「193倍速い・444倍安い」の読み方とJevの料金
比較表で見た速さと料金の差は、宣伝では「193.6倍速い、444.6倍安い」という数字で打ち出されています。ただし、これは提供元が自社の4つの業務の評価で出した数字です(TypeSafe AI)。
比較相手はGPT-6 AstraとFable 5.1で、評価は自社のチームのメンバーが作ったと公式ブログ自身が認めています。実際の効果としては高めの側だという見込みも添えられ、発表の時点で第三者の検証に触れた箇所はありませんでした。
「うちの判定も444倍安くなるのか?」と期待するのは早すぎます。宣伝の数字は提供元の自社評価であり、自分の業務では測り直す必要があるのです。文章を書く作業には、そもそも当てはまらない数字だと考えてください。
Jev 1.13の料金は、入力100万トークンあたり0.042米ドル(約6.6円)で、出力は無料。1回に送れるのは64kトークンまでです(TypeSafe AI)。円は2026年9月24日時点の1米ドル=約158円で換算しました。トークン[6]は、AIが文章を数える単位です。
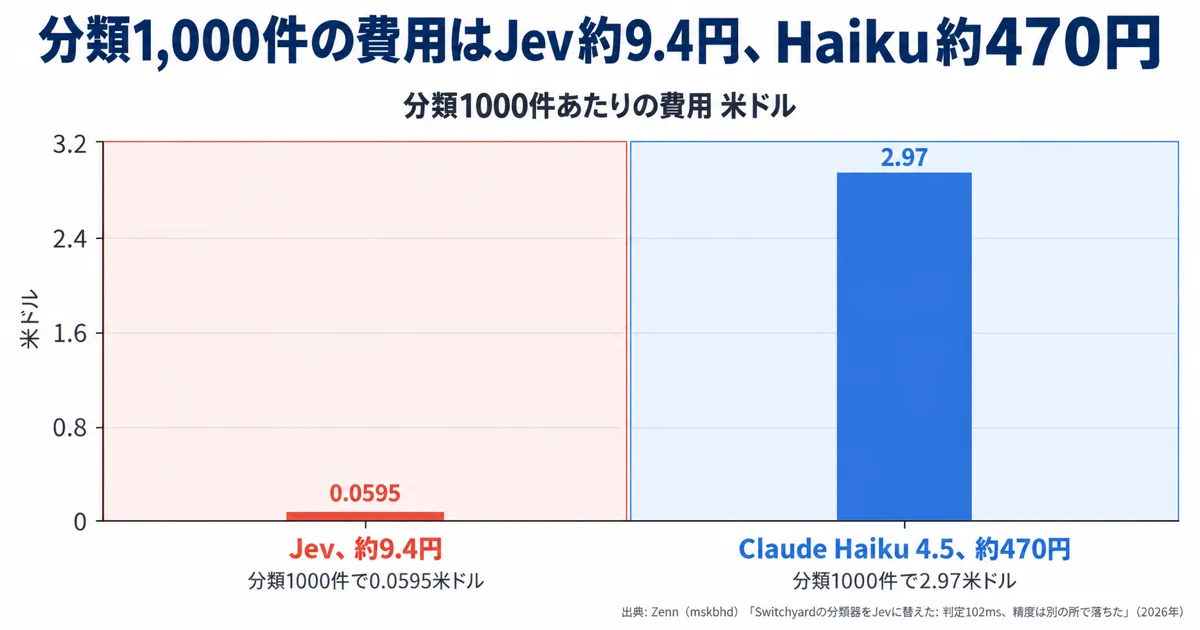
では、第三者が測ると、宣伝と同じ差になるのでしょうか。NVIDIAのSwitchyard[7]の分類器を置き換えた検証(英語の依頼40件)では、分類1,000件あたりJevが0.0595米ドル(約9.4円)、Claude Haiku 4.5が2.97米ドル(約470円)で、筆者は約50倍の差としています(Zenn(mskbhd))。
判定にかかった時間は、Jevがサーバー側で102ミリ秒、手元のGPU[8]で動かした小さなモデルが1,183ミリ秒、Claude Haiku 4.5が1,332ミリ秒でした。
自分の業務の費用は、次の順で見積もってください。
- 今の判定1件分の指示・選択肢・本文をJevに数件送り、1件あたりのトークン数を数える
- その数に、月の件数を掛ける
- 100万トークンあたり0.042米ドルを掛ける
日本語の文字数とトークン数の目安は、公式に記載がありません。参考までに、日本語の問い合わせ54件を送った検証では、入力の合計が31,310トークン、費用は0.0013米ドル(約0.21円)でした(Qiita(mamagotolab))。この数には、問い合わせ文以外の指示の分も含まれている可能性があります。
公開された検証で、Jevの精度が落ちた所
「安いのは分かったけど、精度は落ちないのか?」と気になった方も多いはずです。費用の差がはっきり出た一方で、精度は条件によって上下しました。公開された4つの検証を並べると、次のとおりです。
| 検証 | 試したこと | 精度が落ちた所 | 試した対策 |
|---|---|---|---|
| arXiv[9]の論文 | 選択肢名と基準の文の組み替え | 基準より選択肢名に従った | 意味の無い選択肢名にする |
| Switchyardの置き換え | 英語の依頼40件の段階分け | 「deep」を1度も選ばない | 説明文に具体例を足す |
| 日本語の問い合わせ | 4つの窓口への振り分け | 用件が混ざった文、窓口の境目 | 確信度の低い件を人に回す |
| Jev系OSS[10]のLaya | 日本語の業務メール300件 | 緊急度の採点が位置で決まった | 確率の補正では精度が動かず |
つまり、壊れた答えは返らなくても、中身の間違いは選択肢の名前・説明文・並び順・用件の混ざり方から生まれます。
選択肢の名前に答えが引っ張られる
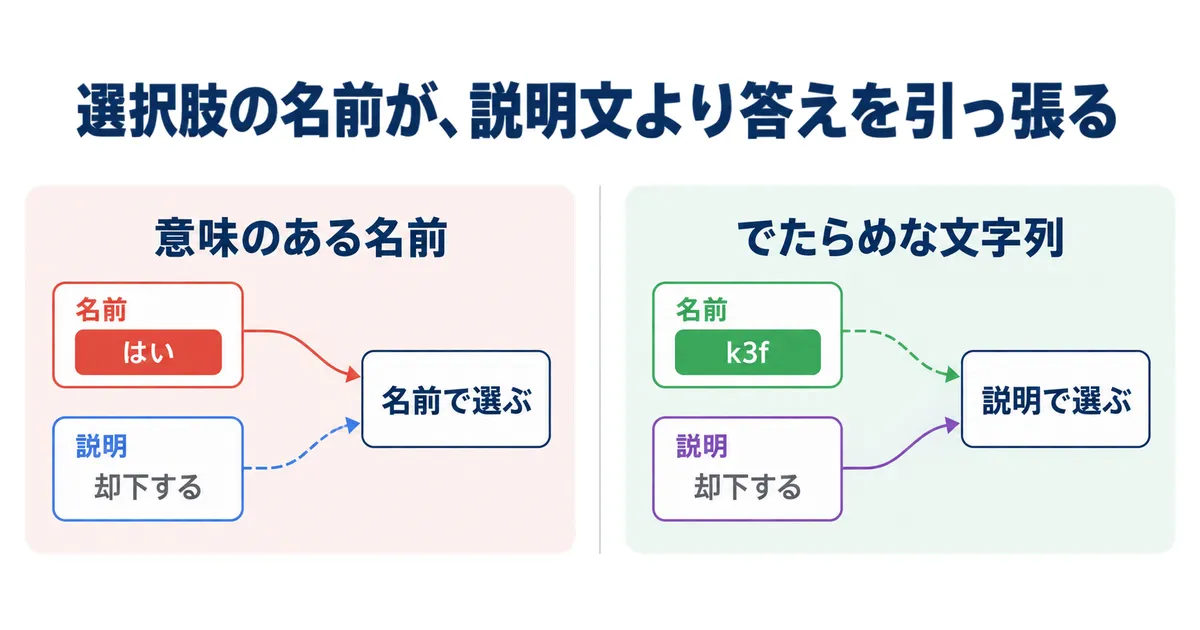
arXivの論文は、問い・情報・基準の文・選択肢名はそのままにして、どの基準の文にどの選択肢名を結びつけるかだけを入れ替えました。1,200件の判定で、選択肢名をno/yesにして入れ替えると、Jevに似た公開モデルでは100件あたり70.4件多く答えが変わりました(arXiv(Yu Sun、Junhao Xu))。
Jev本体でも同じ傾向で、判定の良さを示すAUC[11]が0.8146から0.5806に下がっています。一方、選択肢名をでたらめな文字列にすると、精度を落とさずにこの影響が消えました。
「はい」と書いたボタンに「却下する」という説明を付けたら、説明を読まずにボタンの名前で押してしまう。そんな動きに近いと考えてください。
説明文が抽象的だと、選ばれない選択肢が出る
Switchyardの検証では、正解の段階との一致率がJev 67.5%、Claude Haiku 4.5 56.4%、手元の小さなモデル 47.5% でした(Zenn(mskbhd))。Jevが上回った一方で、推論の深さを表す「deep」は40件中1度も選ばれていません。
説明文に具体例を足すと、Jevは「deep」を4件選ぶようになり、一致率は72.5%に上がりました。選ばれにくい選択肢は、説明文を具体例で書き直すと直ることがあるという結果です。
日本語では、用件が混ざった文と採点の段階で崩れた
注文・修理・請求・対象外の4つの窓口に振り分けた日本語の検証(評価44件)では、用件が1つだけの問い合わせ18件は、確信度の基準0.70でも0.90でも誤りが0件でした(Qiita(mamagotolab))。基準0.90での誤りは、用件が混ざった文で7件中2件、窓口の境目の文で5件中1件、遠回しな表現で4件中1件という内訳。
Jev本体ではなく、Jevの仕組みを真似たOSSのLayaを、日本語の業務メール300件で測った検証もあります。部署を4つから選ぶ判定は正解率0.747で、でたらめに選ぶ場合の3.0倍でした(Zenn(genelab_999))。一方で緊急度の採点では、最下位の「急がない」を1回も選ばず(300件中0回)、提示順が先頭の選択肢はどの条件でも0〜1件しか選ばれませんでした。
Jevに移す判定とLLMに残す判定、確信度で人の確認を決める方法
精度が落ちた場所が分かると、どの判定を移すかの線引きもしやすくなります。移すのは、件数が多く、答えが選択肢で閉じていて、今LLMに1件ずつ投げている判定からです。
移すと安くなる判定、LLMに残す判定
| 判定の種類 | 移す先 | 理由 |
|---|---|---|
| 窓口への振り分け | Jevへ移す候補 | 用件1つの文は日本語でも誤り0件 |
| チケットの分類 | Jevへ移す候補 | 選ぶ判定は日本語でも使える水準 |
| はい・いいえの判定 | Jevへ移す候補 | 選択肢名の付け方に注意する |
| 緊急度などの段階の採点 | 自分のデータで試してから | 日本語で段階が崩れた例がある |
| 理由や返信文が要る判定 | LLMに残す | Jevは文章を作らない |
つまり、選ぶ判定は移す候補、段階の採点は確かめてから、文章が要る判定はLLMのまま、という線引きです。
「この承認可否の判定、Jevに移していいのか……」と迷ったら、答えが選択肢で閉じているかどうかを先に見てください。
確信度の基準で、人が読む件数を決める
確信度は、自動で処理する件と人が確認する件を分けるために使います。公式は、高い件は自動で処理、中くらいは確認や追加の情報集め、低い件は人に回す、という3段階を示しています(TypeSafe AI)。基準は1つの数ではなく、送金の承認のような取り消せない操作には0.9以上を使う例が載っています。
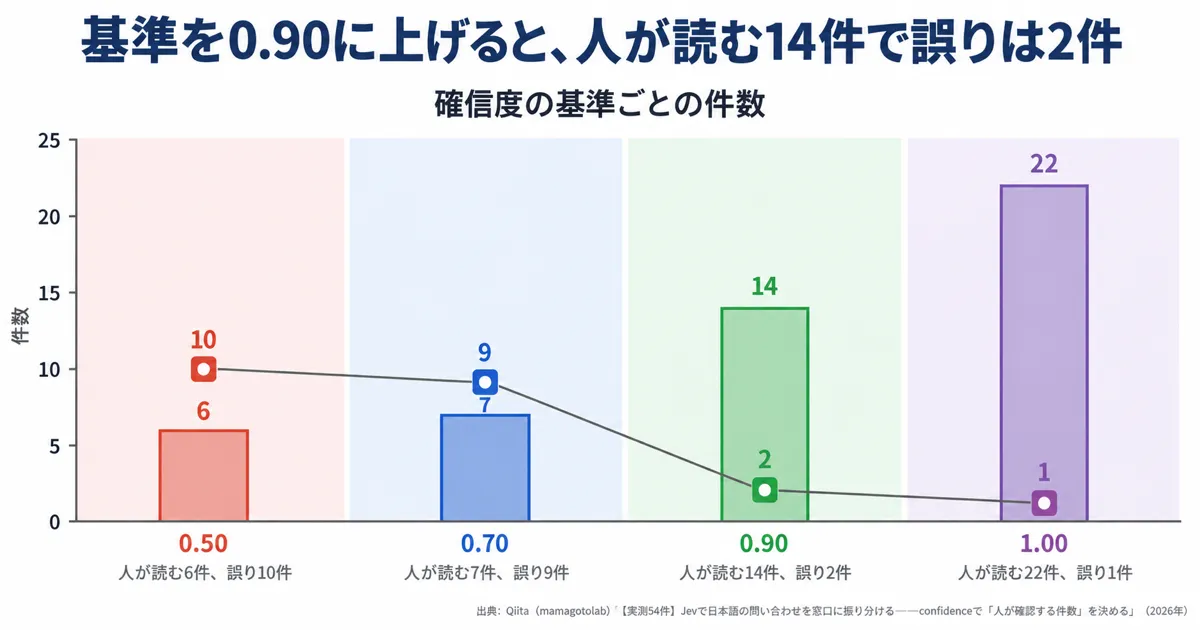
日本語の問い合わせ振り分けの検証(評価44件)では、基準ごとの件数が次のとおりでした(Qiita(mamagotolab))。
- 基準なし:人が44件すべてを確認
- 0.50:人が6件、自動が38件で誤り10件
- 0.70:人が7件、自動が37件で誤り9件
- 0.90:人が14件、自動が30件で誤り2件
- 1.00:人が22件、自動が22件で誤り1件
筆者は、確信度は正解の確率ではなく、確率が1つの選択肢に集まっている度合いだとしています。最大の1.00にしても誤りは消えません。誤ったときの損が大きい業務ほど、基準を上げてください。
なお、Switchyardの検証で確信度の下限による振り分けが有効に働いたのはJevだけでした。文章を生成するモデルが出す確信度は、正解かどうかとの関係が弱かったと筆者は書いています(Zenn(mskbhd))。
よくある質問(FAQ)
線引きと確信度の使い方を見たうえで、よく出る疑問にも短く答えておきます。
Q. Jevにメールの返信文も書かせられますか?
書かせられません。Jevは文章を作らず、選ぶ・点を付ける・確率を出すの3つの判断だけを返します。問い合わせの振り分けはJevに任せ、返信の下書きはLLMに書かせる、と分けて使ってください。
Q. 日本語の問い合わせでも、答えはすぐ返りますか?
日本語の問い合わせ54件を送った個人の検証では、応答時間の中央値が630ミリ秒(487〜872ミリ秒)で、呼び出しの失敗は0件でした(Qiita(mamagotolab))。人が画面の前で待つ使い方でも、1件あたり1秒かからなかった計算です。ただし、日本語の精度は英語と同じ水準ではないと公式も書いているため、速さとは別に確かめてください。
Q. Layaの検証結果は、Jevにもそのまま当てはまりますか?
そのままは当てはまりません。LayaはJevの仕組みを真似たOSSで、中身のモデルが違います。ただ、選択肢の名前に答えが引っ張られる傾向は、arXivの論文でJev本体にも見られました。段階の採点を使うなら、自分のデータで選択肢の並び順を入れ替えて確かめる価値があります。
Jevへの置き換えを試すなら、何から始めるべきか
ここまで読んで、自分のシステムにも移せそうな判定が思い浮かんだ方もいるのではないでしょうか。試すなら、次の3ステップで小さく始めてください。
- ステップ1: 今LLMに投げている判定から、答えが選択肢で閉じていて件数の多いものを1つ選びます。選択肢名と説明文は、具体例を添えて書きます
- ステップ2: AIの答えを見る前に正解を決めた数十件を用意し、Jevと今のLLMで結果を比べます。選択肢名を入れ替えても答えが変わらないかも確かめます
- ステップ3: 確信度の基準をいくつか試し、人が読む件数と誤りの件数を表にして、業務に合う基準を決めます
第三者の実測では約50倍の費用差が出た一方で、精度は選択肢の書き方や説明文で上下しました(Zenn(mskbhd))。費用の差を当てにする前に、自分のデータで数十件を測ってから広げてください。
用語の注釈
- LLM 大規模言語モデルの略です。ChatGPTのように、文章を1語ずつ書いて答えるAIを指します。 ↩
- ルーブリック 段階ごとに「どういう状態ならその点か」を書いた採点の基準表です。 ↩
- API プログラムから別のサービスの機能を呼び出すための窓口です。ここでは、自社のシステムからAIに判定を頼む仕組みを指します。 ↩
- JSON データをやり取りするときの書き方の決まりの1つです。形が崩れると、受け取ったプログラムが読めなくなります。 ↩
- function calling LLMに、決めた項目と形で答えを返させる機能です。 ↩
- トークン AIが文章を数える単位です。AIの利用料金はこの数で決まります。 ↩
- Switchyard NVIDIAの、依頼ごとにどのLLMへ回すかを決める振り分けツールです。 ↩
- GPU AIの計算に使う処理装置です。ここでは、クラウドではなく検証した人の手元の機械で動かしたことを指します。 ↩
- arXiv 研究者が論文を公開するサイトです。専門家の審査を受ける前の論文も載ります。 ↩
- OSS オープンソースソフトウェアの略です。中身が公開され、誰でも使える形で配られているソフトを指します。 ↩
- AUC 判定の良さを0〜1で表す指標です。0.5はでたらめに選ぶのと同じ水準です。 ↩